ABBYY FineReader много лет оставался одним из привычных инструментов для превращения сканов в редактируемый текст. Но в 2026 году текст с фотографии способны извлечь и нейросети. Возникает закономерный вопрос: нужен ли теперь отдельный OCR-редактор или его задачи уже можно поручить искусственному интеллекту?
Ответ зависит не столько от качества распознавания одной страницы, сколько от того, что нужно получить в результате: несколько абзацев для статьи или десятки страниц с таблицами, колонками и исходным оформлением.
Что изменилось с появлением ИИ
Традиционное OCR (оптическое распознавание символов) преобразует изображение букв в текст. Современные ИИ-сервисы могут не только извлечь текст, но и объяснить содержание, перевести его, сократить, сгруппировать данные или подготовить черновик статьи. Для разовой фотографии документа такой подход зачастую удобнее: не нужно открывать отдельный редактор и вручную переносить результат в другую программу.
Но извлечение текста и его интерпретация — разные задачи. Языковая модель может незаметно исправить формулировку, пропустить строку или дополнить плохо читаемый фрагмент по смыслу. Это особенно важно для документов, где каждая цифра и каждое слово должны совпадать с оригиналом. Специализированный OCR тоже ошибается, но предоставляет инструменты для сверки результата с изображением страницы.
Один скан: FineReader или нейросеть?
Представим типичную задачу: есть фотография листа А4, а текст с неё нужно вставить в публикацию. ИИ удобно попросить извлечь текст, сохранить абзацы и отдельно отметить неразборчивые места. После этого можно попросить отредактировать материал — но только после сверки с оригиналом.
FineReader решает задачу иначе: открывает изображение, определяет текстовые области, распознаёт символы и показывает результат рядом с исходной страницей. Это менее универсальный, зато более контролируемый процесс. Пользователь видит, какой участок документа распознаётся, и может исправить ошибки непосредственно в OCR-редакторе.
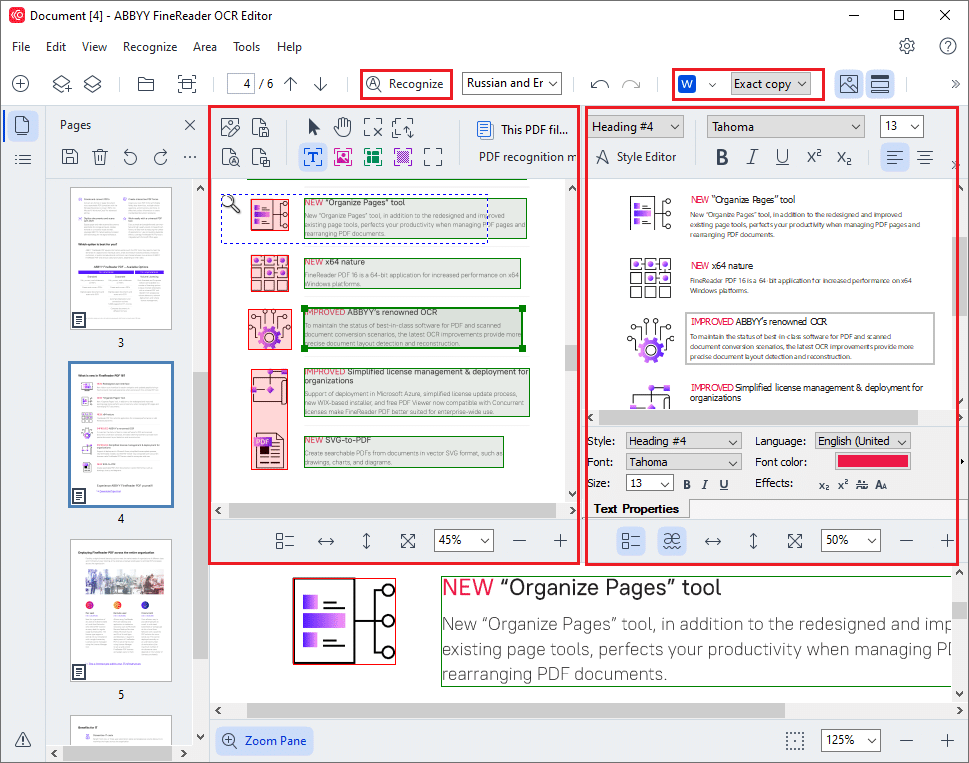
Важно: это сравнение рабочих сценариев, а не результаты лабораторного теста. Точность зависит от качества изображения, языка, шрифта и конкретной ИИ-модели. Без обработки одного и того же набора сканов нельзя обоснованно утверждать, что один инструмент всегда распознаёт текст лучше другого.
Многостраничные документы: преимущество специализированного OCR
Сложности начинаются, когда вместо одного изображения появляется архив из десятков или сотен страниц. Здесь важны последовательность обработки, возможность работать с пакетом документов, проверять отдельные страницы и получать файлы в нужном формате.
FineReader рассчитан именно на такую работу. В редакторе можно управлять страницами, задавать языки распознавания, проверять области текста и сохранять результат. Возможности автоматизации и пакетной обработки зависят от версии и редакции продукта.
ИИ-сервисы тоже умеют работать с PDF и несколькими файлами, однако ограничения по размеру загрузки, количеству страниц и способам экспорта различаются. Кроме того, при больших объёмах особенно важно убедиться, что не пропущены страницы и фрагменты текста.
Таблицы, колонки и оформление
Если нужен только смысл документа, нейросеть может оказаться удобнее. Но когда требуется сохранить расположение заголовков, таблиц, иллюстраций и нескольких текстовых колонок, задача становится сложнее. Обычный ответ ИИ в чате не гарантирует точного воспроизведения макета.
В FineReader области документа размечаются как текст, таблицы и изображения. Пользователь может проверить границы блоков и при необходимости скорректировать их перед экспортом. Это полезно для инструкций, отчётов, старых журналов и других документов со сложной вёрсткой.
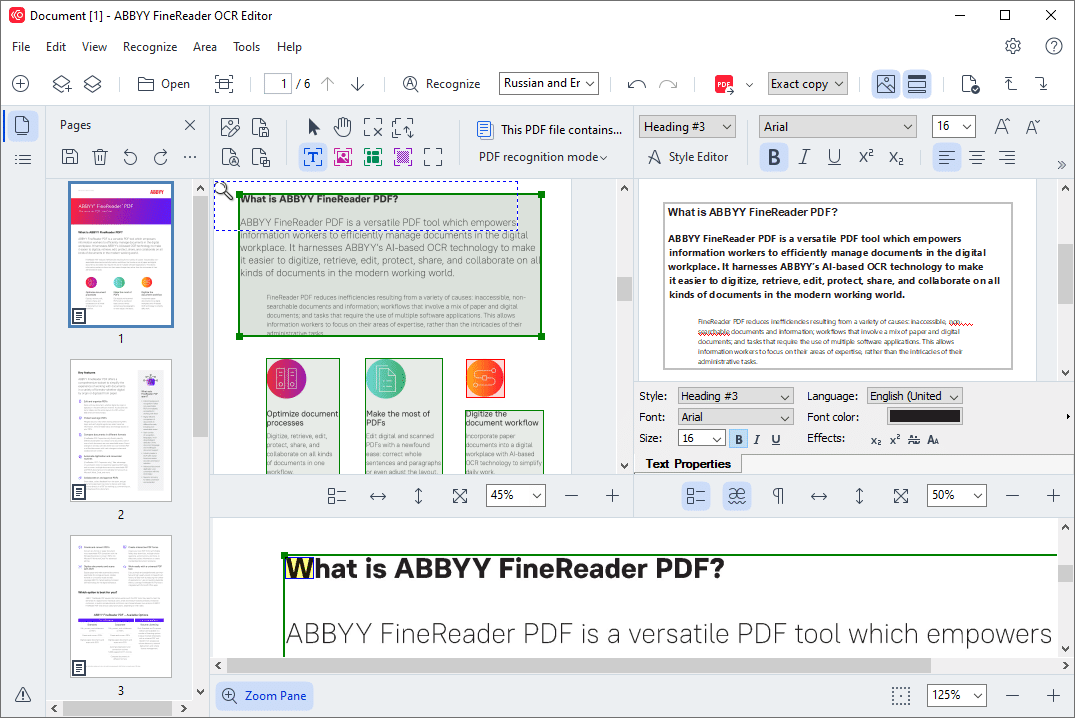
При этом и FineReader не гарантирует идеального результата. Объединённые ячейки, мелкие подписи, плохие сканы и нестандартные шрифты могут потребовать ручной доработки.
Экспорт в Word и PDF: что важнее — текст или документ
Для подготовки статьи иногда достаточно обычного текста без форматирования. В таком случае ИИ может одновременно распознать, структурировать и предложить редактуру. Если же задача — получить редактируемый Word-файл, максимально похожий на исходный документ, специализированный OCR-редактор удобен благодаря настройкам распознавания и экспорта.
С PDF ситуация аналогична. Одно дело — пересказать содержание отсканированного файла, другое — сделать его доступным для поиска по тексту, сохранив визуальный вид страниц. Для второй задачи нужны подходящие инструменты работы с текстовым слоем PDF, а не только чат с нейросетью.
Как использовать FineReader и ИИ вместе
Для редактора сайта эти инструменты не обязательно конкурируют. Практичный сценарий выглядит так: сначала получить точный текст из скана, проверить цифры, имена и абзацы, а затем передать уже вычитанный материал ИИ для подготовки структуры, сокращения или стилистической правки.
- Оцифровать скан или PDF в FineReader и сохранить распознанный текст.
- Сверить текст с оригиналом, особенно даты, таблицы, имена и числовые значения.
- Передать проверенный текст ИИ для подготовки плана статьи, заголовков или редакторской обработки.
- Проверить итоговый материал вручную и только после этого публиковать.
Такой порядок снижает риск того, что ошибки исходного распознавания превратятся в фактические ошибки опубликованной статьи. Для конфиденциальных документов отдельно следует оценить, допустима ли их передача стороннему облачному ИИ-сервису.
Нужен ли ABBYY FineReader в 2026 году?
Да, если требуется регулярно оцифровывать многостраничные документы, контролировать точность распознавания и сохранять структуру при экспорте. Для одной фотографии, небольшого фрагмента текста или подготовки краткого пересказа ИИ часто оказывается более быстрым и удобным решением.
Поэтому FineReader уже не выглядит обязательной программой для каждого пользователя компьютера. Но и считать его устаревшим из-за нейросетей преждевременно: ИИ хорошо помогает работать с содержанием, а специализированный OCR остаётся полезным там, где важны воспроизводимость и контроль исходного документа.
Актуальные возможности и редакции программы представлены на официальном сайте ABBYY FineReader PDF.



Здравствуйте. Подскажите специалиста по наливным полам. Рассыпался полам в ангаре – старый, бетонный. Порылся в нете, решил сделать наливной. Что почем – не смог найти. Прошу помощи.